Soporte continuo y SRE en República Dominicana
Operamos y mejoramos tus plataformas después de la salida a producción: monitoreo, respuesta a incidentes, parches, costos y fiabilidad. Para empresas e instituciones de RD y LATAM que necesitan que sus sistemas críticos estén disponibles sin mantener un equipo de operaciones completo.
Agendar diagnóstico de 30 min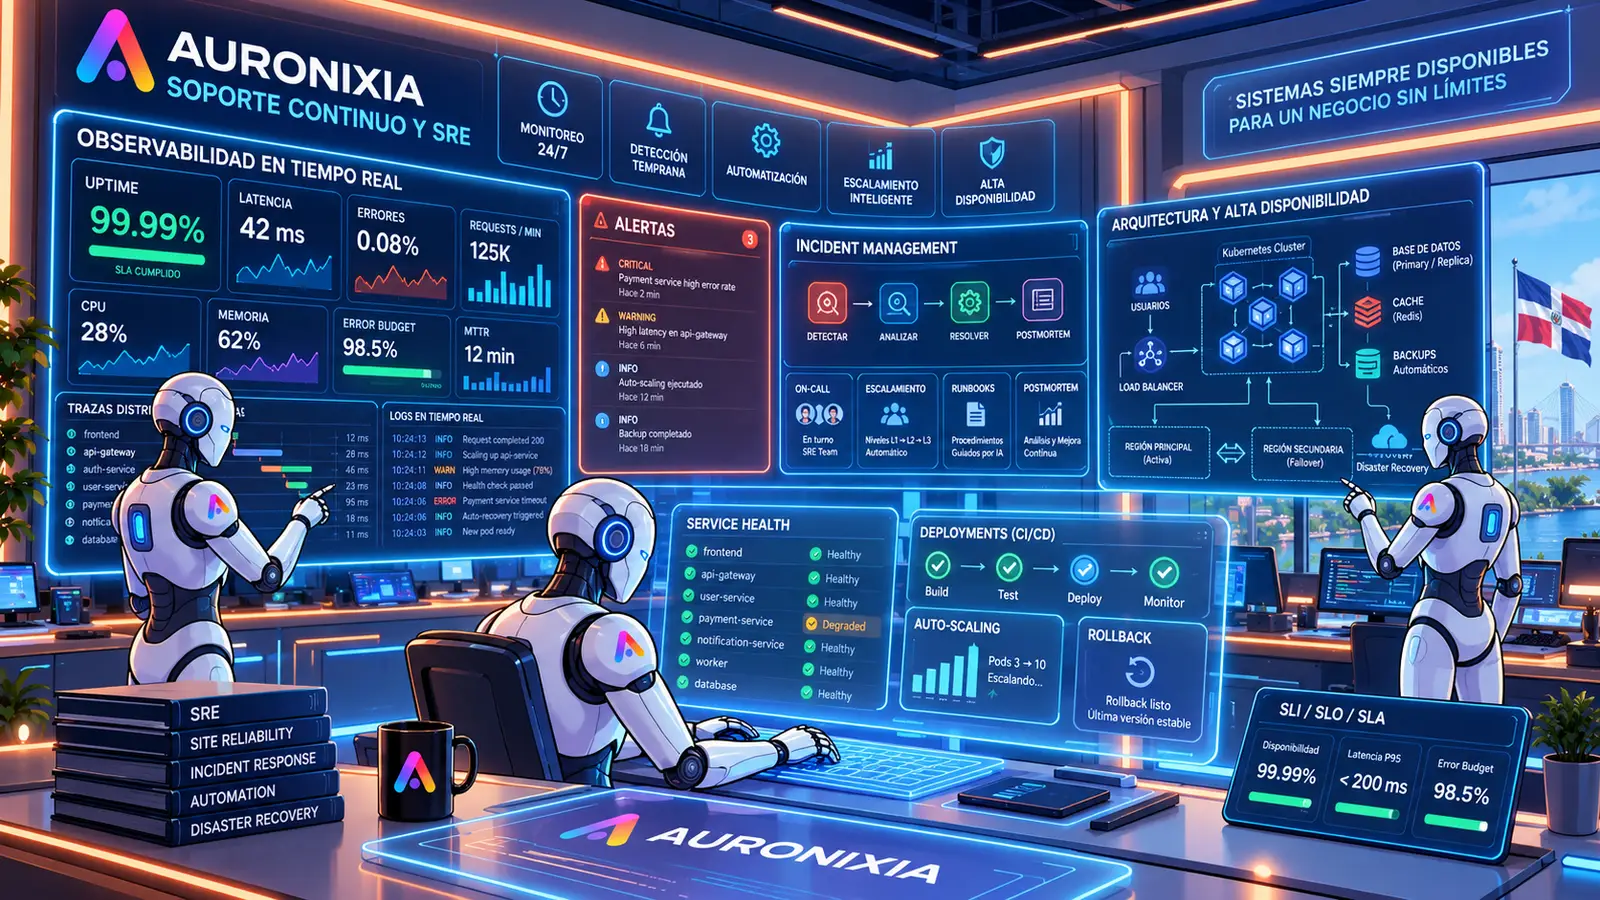
Poner un sistema en producción es el comienzo, no el final. Después llegan las actualizaciones de seguridad, los picos de tráfico, los cambios de los proveedores de nube y los incidentes que aparecen a las tres de la mañana. Sin un proceso claro, el equipo vive apagando fuegos y las mejoras se posponen.
SRE (Site Reliability Engineering) es la disciplina que aplica ingeniería a la operación. En lugar de prometer «disponibilidad total», se acuerdan objetivos de fiabilidad medibles para cada servicio y se trabaja con datos para cumplirlos, automatizando las tareas repetitivas.
Problemas que resolvemos
- Incidentes que se detectan cuando un cliente llama, no cuando empiezan.
- La operación depende de una o dos personas que conocen el sistema.
- Parches de seguridad y actualizaciones que se acumulan durante meses.
- Costos de nube que crecen sin revisión periódica.
- Falta de documentación y de procedimientos para responder a incidentes.
- Despliegues que provocan caídas y se hacen fuera de horario por miedo.
Enfoque y metodología
- Evaluación inicial. Revisamos la arquitectura, el monitoreo, los respaldos, la seguridad y los procesos de despliegue actuales.
- Objetivos de servicio. Definimos con tu equipo los indicadores (SLI) y objetivos (SLO) de cada servicio crítico, y los niveles de servicio del contrato.
- Observabilidad. Métricas, logs, trazas y alertas accionables que avisan antes de que el problema llegue al usuario.
- Operación. Guardias, gestión de incidentes con análisis posterior sin culpables, parches y cambios planificados.
- Mejora continua. Revisiones mensuales de fiabilidad, costos y seguridad, y automatización del trabajo repetitivo.
Entregables
- Informe de evaluación inicial con riesgos priorizados.
- Catálogo de servicios con SLI, SLO y niveles de servicio acordados.
- Monitoreo, tableros y alertas configurados.
- Runbooks de operación y procedimiento de gestión de incidentes.
- Informe mensual de disponibilidad, incidentes, costos y acciones.
- Pruebas periódicas de respaldo y recuperación.
Plazos típicos
| Alcance | Plazo orientativo |
|---|---|
| Evaluación inicial | 2–3 semanas |
| Puesta en marcha de monitoreo y procesos | 3–6 semanas |
| Operación con niveles de servicio | Continuo, por mes |
| Revisión de fiabilidad y costos | Mensual |
Stack relevante
- Prometheus
- Grafana
- OpenTelemetry
- CloudWatch / Azure Monitor
- Datadog
- PagerDuty / Opsgenie
- Terraform
- Kubernetes
- GitHub Actions
Niveles de servicio claros
Cada contrato define el horario de cobertura, los tiempos de respuesta por severidad y los canales de escalamiento. Los niveles se acuerdan según la criticidad de cada sistema; no todos los servicios necesitan cobertura las 24 horas, y pagar por ella cuando no hace falta encarece la operación.
Incidentes que dejan aprendizaje
Después de cada incidente relevante documentamos qué pasó, por qué, cómo se detectó y qué cambios evitan que se repita. El objetivo es mejorar el sistema, no buscar culpables, y compartimos el análisis con tu equipo.
Trabajamos con tu equipo
Podemos asumir la operación completa o complementar a tu equipo interno en horarios, tecnologías o servicios concretos. En ambos casos el conocimiento queda documentado en tus repositorios.
Qué incluye un mes de operación
- Monitoreo continuo de los servicios acordados y atención de alertas según su severidad.
- Aplicación de parches de seguridad y actualizaciones planificadas, con ventana y plan de reversa.
- Revisión de respaldos y prueba periódica de restauración.
- Seguimiento de los objetivos de servicio y del presupuesto de errores de cada sistema.
- Reunión mensual con el informe de incidentes, costos, riesgos y mejoras propuestas.
Preguntas frecuentes
¿Qué diferencia hay entre soporte tradicional y SRE?
El soporte tradicional reacciona a incidentes. SRE además mide la fiabilidad con objetivos acordados, automatiza tareas repetitivas y prioriza mejoras con datos, para que haya menos incidentes con el tiempo.
¿Ofrecen cobertura 24/7?
Sí, para los servicios que lo requieren. Definimos la cobertura por sistema según su criticidad, con tiempos de respuesta por severidad establecidos en el contrato.
¿Pueden dar soporte a sistemas que no construyeron ustedes?
Sí. Empezamos con una evaluación inicial para conocer la plataforma, documentarla y corregir los riesgos más urgentes antes de asumir compromisos de nivel de servicio.
¿El servicio incluye la optimización de costos de nube?
Sí. Revisamos el gasto cada mes, identificamos recursos sobredimensionados o sin uso y proponemos ajustes, siempre sin afectar los objetivos de fiabilidad.
¿Hablamos de tu proyecto?
Respondemos en 24 h hábiles · Firmamos NDA antes de cualquier análisis.